AI agent memory를 설계할 때 가장 위험한 오해는 memory를 저장소 이름으로만 보는 것입니다. Vector DB를 붙이거나 대화 로그를 길게 남기면 에이전트가 똑똑해질 것처럼 보이지만, 실제 운영에서는 무엇을 기억할지와 무엇을 잊을지가 더 중요합니다.
이 글에서는 Memory를 저장소가 아니라 정책으로 다룹니다. 4편에서 RAG를 context layer로 봤다면, 5편에서는 에이전트가 기억을 쓰고 읽고 삭제하고 검증하는 기준을 잡겠습니다.
LangChain은 short-term memory와 long-term memory를 나누어 설명하고, OpenAI Agents SDK는 Sessions에서 대화 기록을 자동으로 유지하는 구조를 설명합니다. 이 글은 특정 프레임워크 사용법보다 운영 기준에 집중합니다.
AI agent memory는 왜 정책이어야 할까
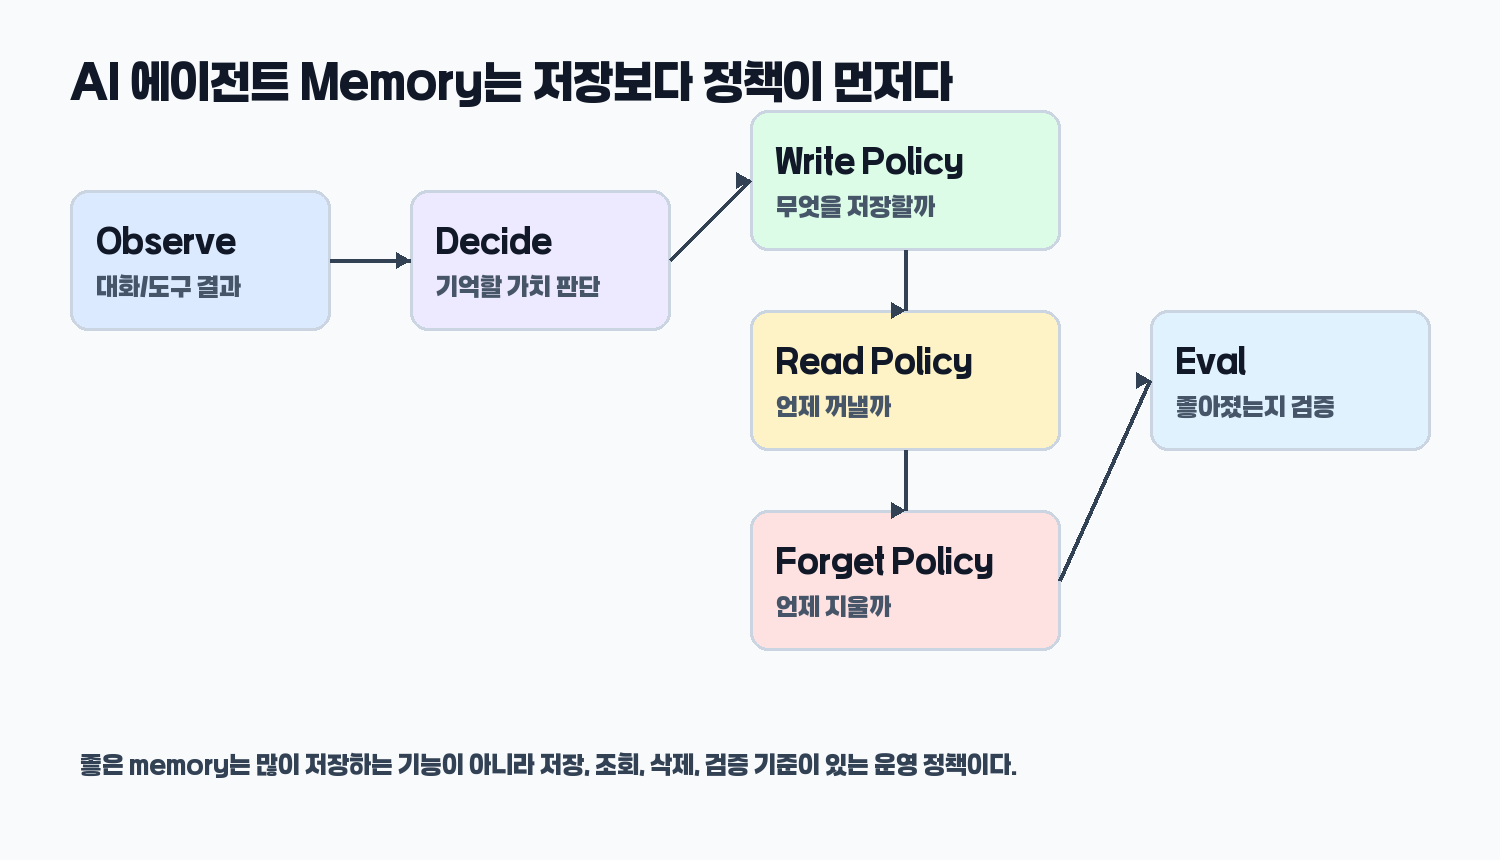
에이전트가 모든 대화를 무조건 기억하면 편해 보입니다. 하지만 실제로는 오래된 정보, 민감한 정보, 잘못 추론한 정보, 임시 작업 정보가 섞입니다. 이 상태에서 에이전트가 기억을 무조건 신뢰하면 오히려 품질이 떨어질 수 있습니다.
그래서 memory의 첫 번째 질문은 “어디에 저장할까”가 아니라 “무엇을 기억할 가치가 있는가”입니다. 저장소는 그 다음 문제입니다.
short-term memory는 현재 작업을 이어가기 위한 기억이다
short-term memory는 현재 대화나 현재 작업을 이어가기 위한 기억입니다. 예를 들어 사용자가 방금 고른 옵션, 아직 끝나지 않은 승인 흐름, 방금 호출한 도구 결과가 여기에 들어갑니다.
이 기억은 오래 남길 필요가 없을 수 있습니다. 현재 작업이 끝나면 사라져도 됩니다. OpenAI Agents SDK의 sessions처럼 대화 기록을 유지하는 기능은 이런 맥락을 이어가게 해주지만, 세션에 들어간 모든 정보가 장기 기억이 되는 것은 아닙니다.
- 현재 작업 목표
- 방금 받은 사용자 선택
- 진행 중인 도구 호출 결과
- 아직 확정되지 않은 초안 상태
long-term memory는 반복해서 쓸 가치가 있는 기억이다
long-term memory는 여러 세션을 넘어 다시 쓸 가치가 있는 정보입니다. 예를 들어 사용자의 선호, 팀의 코드 규칙, 반복 업무 절차, 검증된 프로젝트 구조 같은 정보가 여기에 들어갈 수 있습니다.
하지만 장기 기억은 위험도 함께 큽니다. 오래된 선호가 바뀌었는데 계속 적용될 수 있고, 한 번 잘못 저장한 정보가 계속 영향을 줄 수 있습니다. 그래서 장기 기억에는 작성 시점, 출처, 수정 가능성, 삭제 기준이 함께 있어야 합니다.
retrieval memory와 RAG는 겹치지만 같지 않다
RAG는 외부 문서나 지식 베이스에서 근거를 찾아 context로 넣는 흐름입니다. 반면 retrieval memory는 에이전트가 이전 상호작용이나 사용자/업무 맥락에서 필요한 기억을 다시 꺼내는 흐름에 가깝습니다.
둘 다 검색을 쓰기 때문에 Vector DB나 embedding이 등장할 수 있습니다. 하지만 목적은 다릅니다. RAG는 보통 문서 근거를 찾고, memory는 에이전트의 행동을 개인화하거나 작업 연속성을 유지하는 데 더 가깝습니다. 이 경계는 4편 RAG는 에이전트 안에서 어디에 들어갈까와 함께 보면 더 선명합니다.
Agent memory policy는 네 가지로 나눈다
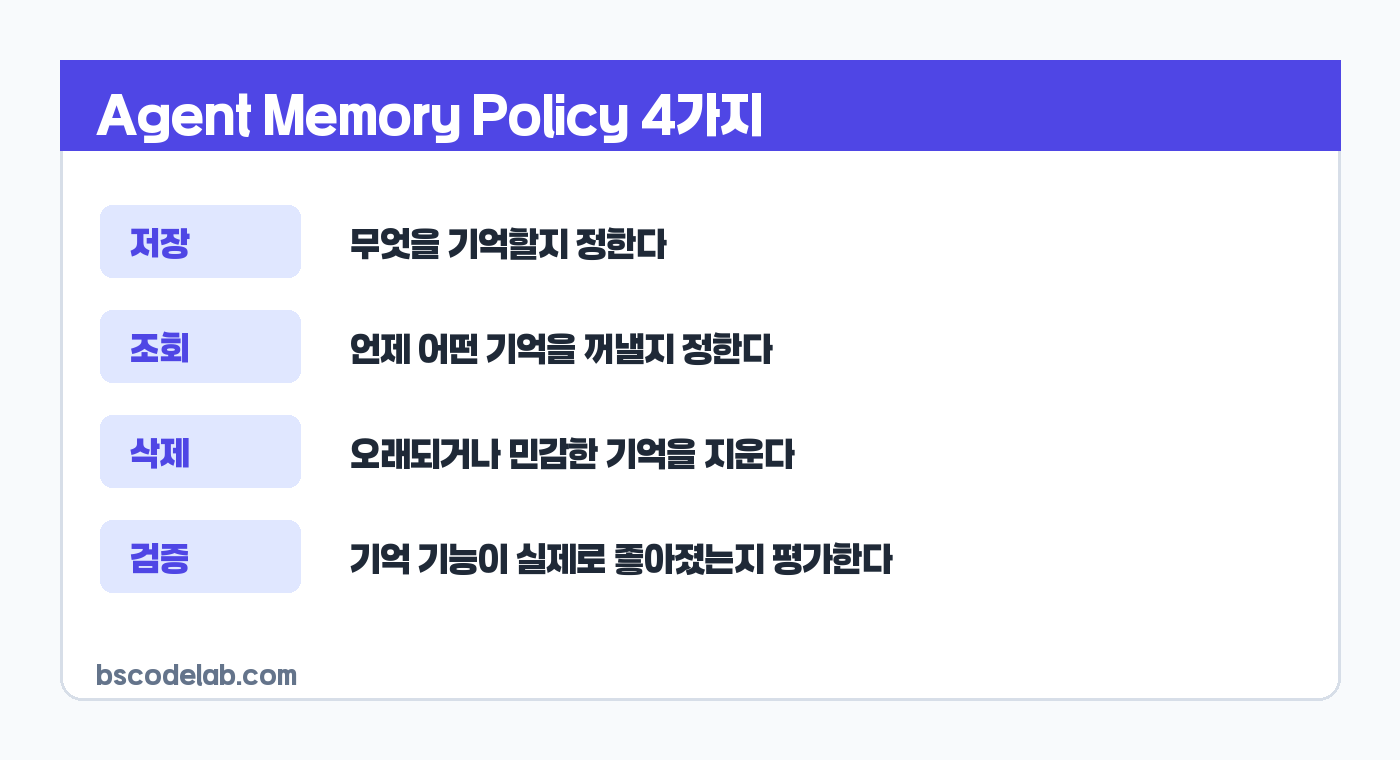
memory policy는 최소한 네 가지 질문으로 나누어야 합니다. 저장 정책, 조회 정책, 삭제 정책, 검증 정책입니다. 이 네 가지가 없으면 memory는 기능처럼 보이지만 운영 기준이 없는 상태가 됩니다.
memory_policy:
  write:
    store_when: ["반복 사용될 선호", "사용자가 명시적으로 저장 요청", "검증된 업무 규칙"]
    do_not_store: ["민감정보", "일회성 추정", "확정되지 않은 초안"]
  read:
    use_when: ["현재 작업과 직접 관련", "최신성 확인 가능"]
  forget:
    expire_after: "업무 성격에 따라 지정"
    delete_on_request: true
  eval:
check: ["정확도", "불필요한 개입", "개인정보 노출", "오래된 기억 사용"]잘못된 memory가 만드는 실패
memory는 잘 쓰면 편하지만, 잘못 쓰면 에이전트를 더 위험하게 만듭니다. 가장 흔한 실패는 잘못된 기억을 사실처럼 쓰는 것입니다. 사용자가 한 번 임시로 말한 조건을 영구 선호로 저장하거나, 추정한 내용을 검증된 규칙처럼 저장하면 문제가 생깁니다.
- 임시 요청을 장기 선호로 저장한다.
- 사용자가 바꾼 결정을 오래된 기억이 덮어쓴다.
- 개인정보를 기억하고 필요 없는 작업에도 다시 꺼낸다.
- 검색된 기억의 출처와 작성 시점을 보여주지 않는다.
- memory가 답변 품질을 높였는지 평가하지 않는다.
MemGPT 논문은 제한된 context window를 다루기 위해 memory hierarchy와 paging 관점을 제시했습니다. 이 흐름은 memory가 단순 저장소가 아니라 context를 어떻게 관리할지의 문제라는 점을 잘 보여줍니다.
memory eval 없이 memory 기능을 믿으면 안 된다
memory 기능을 넣었다면 좋아졌는지 검증해야 합니다. 단순히 기억이 많아졌다는 것은 품질 지표가 아닙니다. 오히려 잘못된 기억을 많이 꺼내면 답변이 더 나빠질 수 있습니다.
검증할 때는 성공 사례만 모으면 안 됩니다. 기억이 없어야 하는 상황, 오래된 기억을 버려야 하는 상황, 민감정보를 꺼내면 안 되는 상황을 함께 테스트해야 합니다. 이 주제는 AI agent memory eval 글과도 이어집니다.
Agent memory policy 체크리스트
- 이 기억은 현재 작업용인가, 여러 세션을 넘어 다시 쓸 정보인가?
- 사용자가 명시적으로 저장을 요청했는가, 아니면 에이전트가 추정한 것인가?
- 기억의 출처, 작성 시점, 신뢰도를 함께 남길 수 있는가?
- 기억을 조회할 때 현재 작업과 직접 관련 있는지 검사하는가?
- 사용자가 삭제를 요청하거나 시간이 지나면 지울 수 있는가?
- memory가 답변 품질과 안전성을 실제로 높였는지 평가하는가?
정리
AI agent memory는 저장소를 붙이는 문제가 아닙니다. 무엇을 기억하고, 언제 꺼내고, 언제 잊고, 어떻게 검증할지의 정책 문제입니다. short-term memory는 현재 작업을 이어가게 하고, long-term memory는 반복되는 선호와 업무 규칙을 다룹니다. 하지만 둘 다 정책이 없으면 오래된 정보와 민감한 정보가 섞여 에이전트 품질을 떨어뜨릴 수 있습니다.
다음 6편에서는 이 기억과 도구, 승인 흐름을 묶어 Agent workflow를 어떻게 쪼개야 유지보수하기 쉬운지 다루겠습니다.


