DAG DP가 어렵게 느껴지는 가장 큰 이유는, 많은 사람이 위상 정렬과 DP를 따로 배웠기 때문입니다. 위상 정렬은 순서를 만드는 그래프 알고리즘처럼, DP는 배열 점화식처럼 익혔기 때문에 둘이 만나면 전혀 다른 문제처럼 보입니다.
하지만 핵심은 의외로 단순합니다. 사이클이 없는 그래프에서, 먼저 계산이 끝난 정점의 값을 다음 정점으로 전파한다는 감각만 잡히면 됩니다.
DAG DP는 무엇을 하는 문제일까
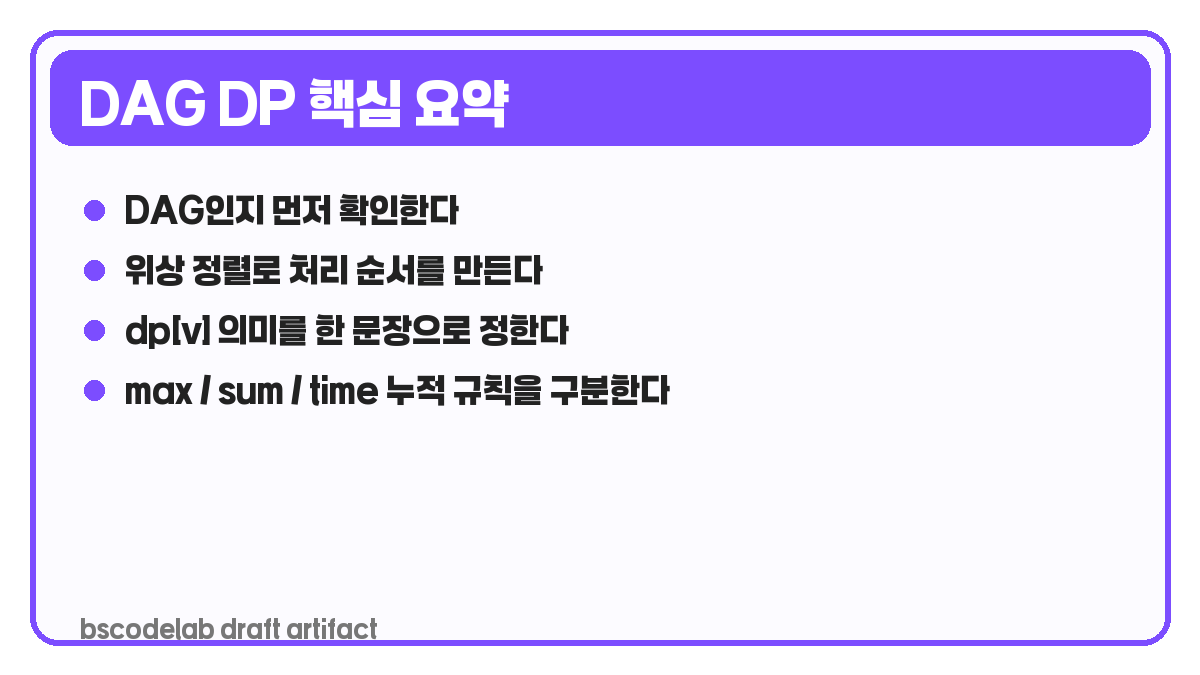
DAG DP는 방향 그래프 위에서 어떤 값을 누적하거나 비교하는 문제입니다. 대표적으로 최장 경로, 최대 점수 경로, 경로 수 세기, 선행 작업 완료 시간 계산 같은 문제에서 자주 등장합니다.
이때 중요한 전제는 그래프가 DAG여야 한다는 점입니다. 즉 방향은 있지만 사이클은 없어야 합니다. 사이클이 있으면 “먼저 계산해야 할 값”이 서로 물고 돌아가므로 전파 순서를 깔끔하게 정할 수 없습니다.
왜 위상 정렬 다음 단계로 자연스럽게 이어질까
위상 정렬은 간선 방향을 어기지 않는 처리 순서를 만듭니다. DAG DP는 그 순서 위에서 값을 채우는 작업입니다. 즉 위상 정렬이 “누구부터 볼지”를 정해 주고, DP가 “무슨 값을 저장할지”를 정해 줍니다.
이렇게 보면 DAG DP는 위상 정렬과 DP의 억지 결합이 아닙니다. 오히려 위상 정렬 글에서 배운 진입차수 순서를, DP 글에서 배운 상태 정의와 결합한 형태라고 보는 편이 더 정확합니다.
입문자가 가장 많이 막히는 지점은 상태 정의다
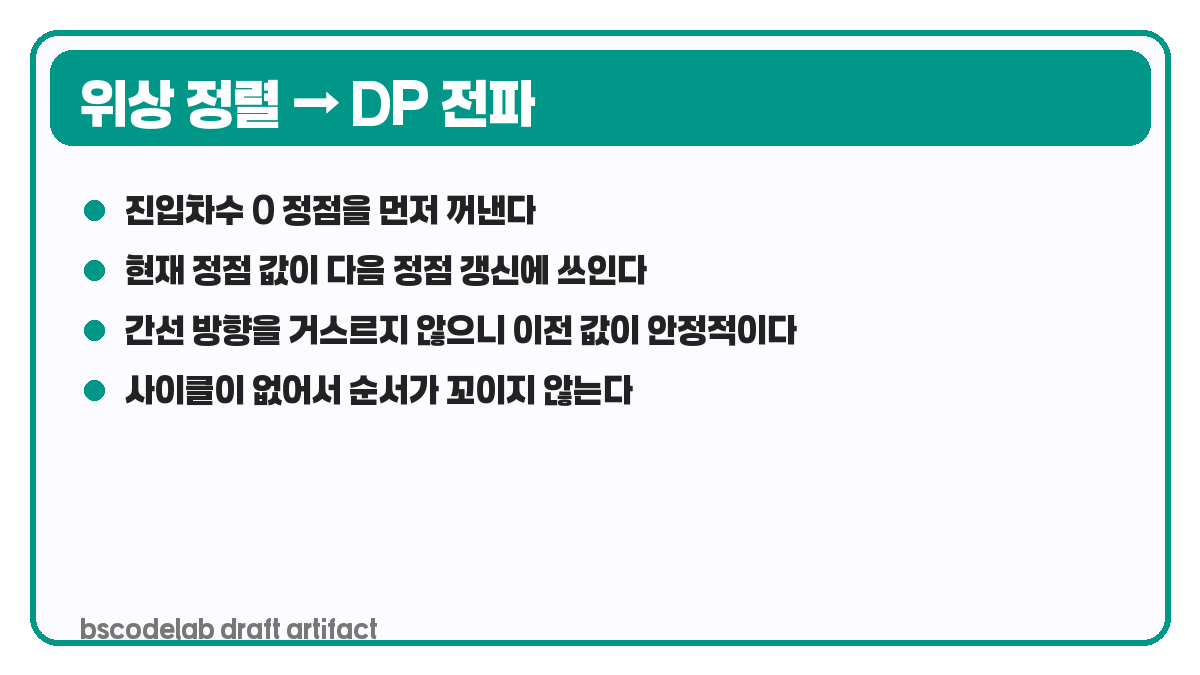
DAG DP에서 핵심은 결국 dp 배열의 의미입니다. 예를 들어 dp[v]를 “정점 v에 도착했을 때 얻을 수 있는 최대 점수”로 둘지, “v까지 오는 경로 수”로 둘지, “v를 끝점으로 하는 최장 길이”로 둘지가 먼저 정해져야 합니다.
여기서 흔한 실수는 그래프만 보고 바로 코드부터 쓰는 것입니다. 그러면 위상 정렬까지는 맞게 구현했는데, dp[v]를 갱신할 때 무엇을 더하고 무엇을 max 해야 하는지 계속 헷갈립니다.
- 문제에서 각 정점에 어떤 값을 저장할지 먼저 한 문장으로 정한다
- 간선 u → v가 있을 때 dp[v]가 dp[u]에서 어떻게 갱신되는지 적는다
- 위상 정렬 순서대로 정점을 보며 전파한다
- 초기값이 시작 정점인지, 진입차수 0 전체인지 구분한다
가장 쉬운 예시: DAG에서 최장 경로 길이 구하기
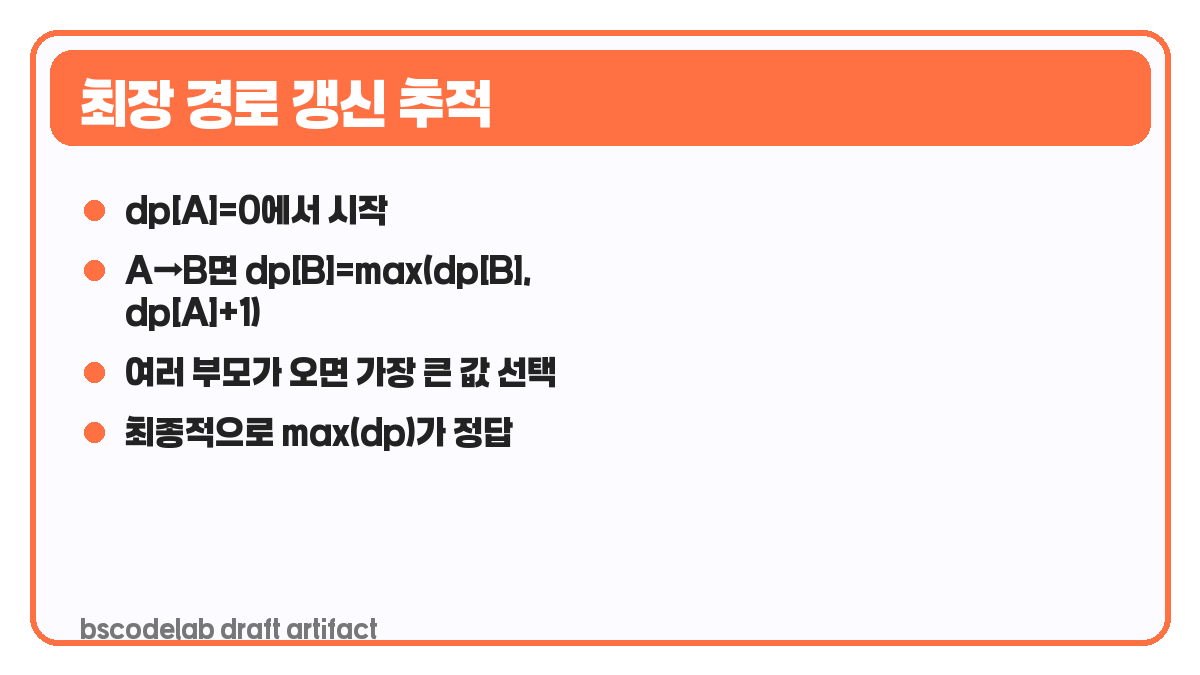
가장 대표적인 예시는 “정점 v에 도착하는 최장 경로 길이”를 구하는 문제입니다. 일반 그래프의 longest path는 어렵지만, DAG에서는 사이클이 없기 때문에 이전 값이 확정된 순서대로 안전하게 계산할 수 있습니다.
from collections import deque

def longest_path_dag(n, graph, indegree):
    dp = [0] * n
    q = deque(i for i in range(n) if indegree[i] == 0)

    while q:
        cur = q.popleft()
        for nxt in graph[cur]:
            dp[nxt] = max(dp[nxt], dp[cur] + 1)
            indegree[nxt] -= 1
            if indegree[nxt] == 0:
                q.append(nxt)

return max(dp)여기서 중요한 부분은 dp[nxt] = max(dp[nxt], dp[cur] + 1) 입니다. 즉 이전 정점 cur까지의 최장 길이가 이미 계산되어 있으니, 그 값에 간선 하나를 더해 다음 정점 후보를 갱신합니다.
경로 수 세기 문제로 바꾸면 무엇이 달라질까
이 구간이 중요한 이유는 DAG DP가 결국 하나의 공식이 아니라 상태 정의의 틀이라는 점을 보여주기 때문입니다. 최장 경로에서는 max가 자연스럽고, 경로 수 세기에서는 sum이 자연스럽습니다.
즉 DAG DP가 어렵게 느껴지는 핵심은 위상 정렬이 아니라, 같은 그래프 위에서도 무엇을 누적할지 먼저 결정해야 한다는 점입니다.
같은 DAG라도 저장하는 값이 바뀌면 점화식도 바뀝니다. 예를 들어 dp[v]를 “v까지 오는 경로 수”로 정의하면 max 대신 합을 써야 합니다.
# 시작점 start 에서 각 정점까지 가는 경로 수
dp[start] = 1
for cur in topo_order:
    for nxt in graph[cur]:
dp[nxt] += dp[cur]이 예시가 중요한 이유는 DAG DP가 특정 문제 하나의 이름이 아니라는 점을 보여주기 때문입니다. 저장하는 값이 길이인지, 점수인지, 경우의 수인지에 따라 완전히 다른 문제를 같은 틀로 해결할 수 있습니다.
문제에서 어떤 신호가 보이면 DAG DP를 의심해야 할까
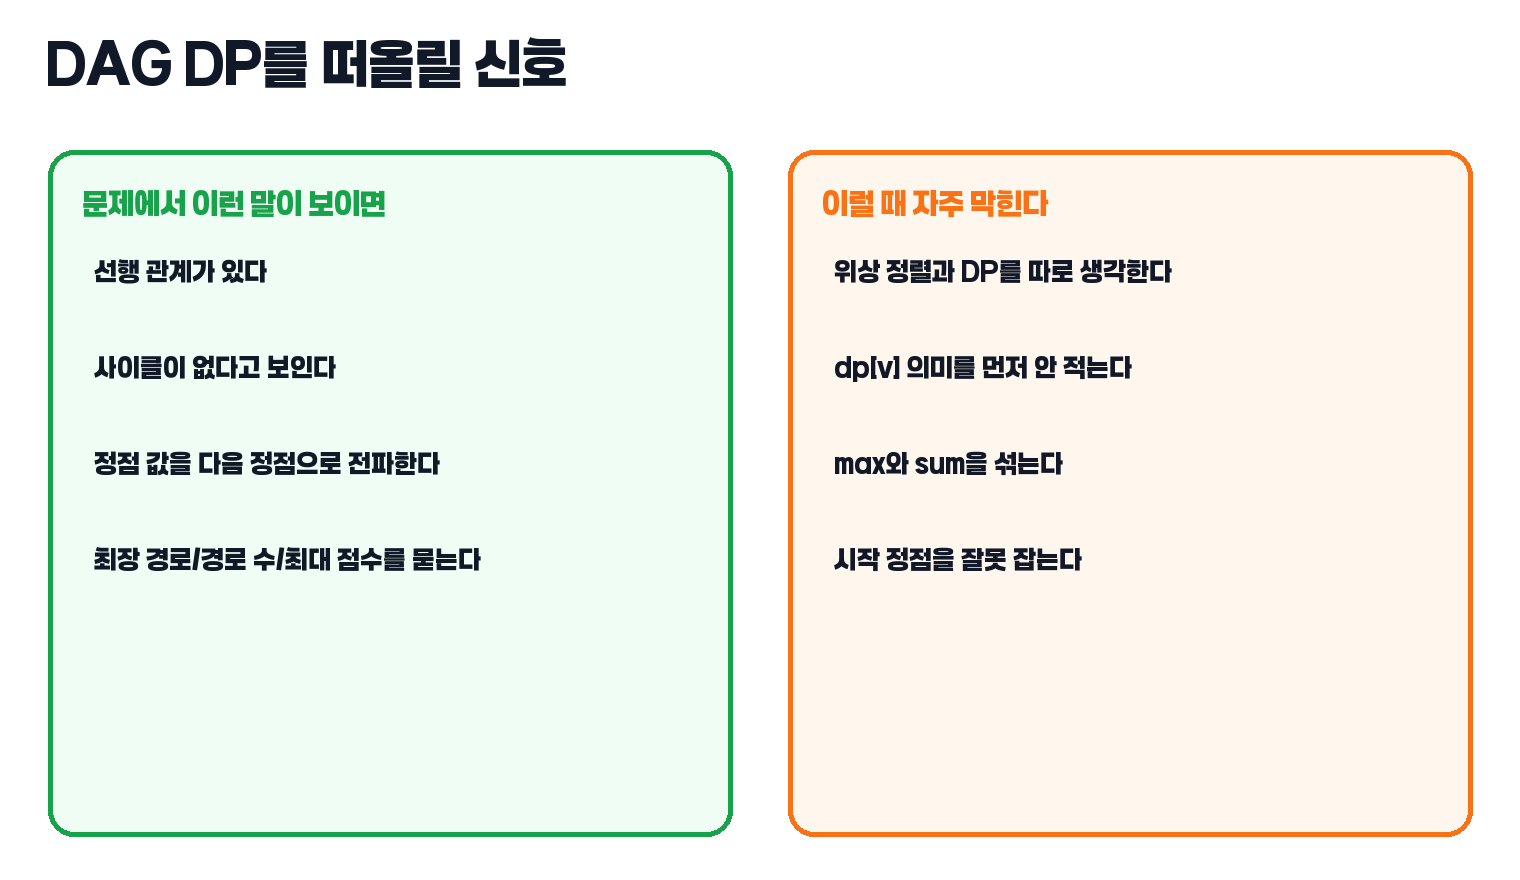
- 선후관계가 있어 순서를 먼저 정해야 한다
- 각 정점이나 작업에 점수, 시간, 경우의 수 같은 값이 붙어 있다
- 이전 작업 결과가 다음 작업 결과에 영향을 준다
- 사이클이 없거나, DAG라고 명시되어 있다
예를 들어 “선수 과목을 만족하면서 가장 오래 걸리는 이수 시간”, “의존성을 지키며 최대 점수를 얻는 경로”, “선행 관계가 있는 작업의 전체 완료 시간” 같은 문장은 위상 정렬만으로는 부족하고, 그 위에 값 전파가 필요하다는 신호입니다.
자주 하는 실수
- 그래프가 DAG인지 확인하지 않고 DP를 붙인다
- dp[v]의 의미를 애매하게 둔 채 구현부터 시작한다
- 진입차수 0인 모든 정점을 시작점으로 봐야 하는 문제와 특정 시작점이 있는 문제를 섞는다
- max를 써야 할 문제와 합을 써야 할 문제를 혼동한다
특히 세 번째 실수가 많습니다. 어떤 문제는 모든 진입차수 0 정점이 시작 후보가 되고, 어떤 문제는 시작점이 하나로 고정됩니다. 이 차이를 놓치면 위상 정렬 구현은 맞아도 답이 달라집니다.
마무리
DAG DP는 새로운 괴물이 아닙니다. 위상 정렬로 순서를 만들고, 그 순서대로 DP 값을 전파하는 방식이라고 이해하면 훨씬 단순해집니다.
그래서 앞으로 문제를 볼 때는 “사이클이 없는 선후관계 그래프인가?”, “각 정점에 저장할 값이 있는가?”를 먼저 확인해 보세요. 이 두 조건이 동시에 보이면 DAG DP가 자연스럽게 떠오를 가능성이 큽니다.
개념 참고는 topological sorting, DAG, longest path problem 정리도 함께 보면 좋습니다.


