LangGraph state를 이해하면 AI agent workflow가 단순 함수 호출 묶음이 아니라는 점이 보입니다. 오래 걸리는 작업, 중간 승인, 실패 후 재시작이 들어가면 state와 checkpoint가 구조의 중심이 됩니다.
핵심은 state는 작업이 흘러가는 기록이고, checkpoint는 그 기록을 잃지 않게 저장하는 장치라는 점입니다. 이 글은 LangGraph를 처음 운영 구조로 보려는 개발자를 위해 state, checkpoint, interrupt를 한 흐름으로 정리합니다.
LangGraph state는 무엇인가
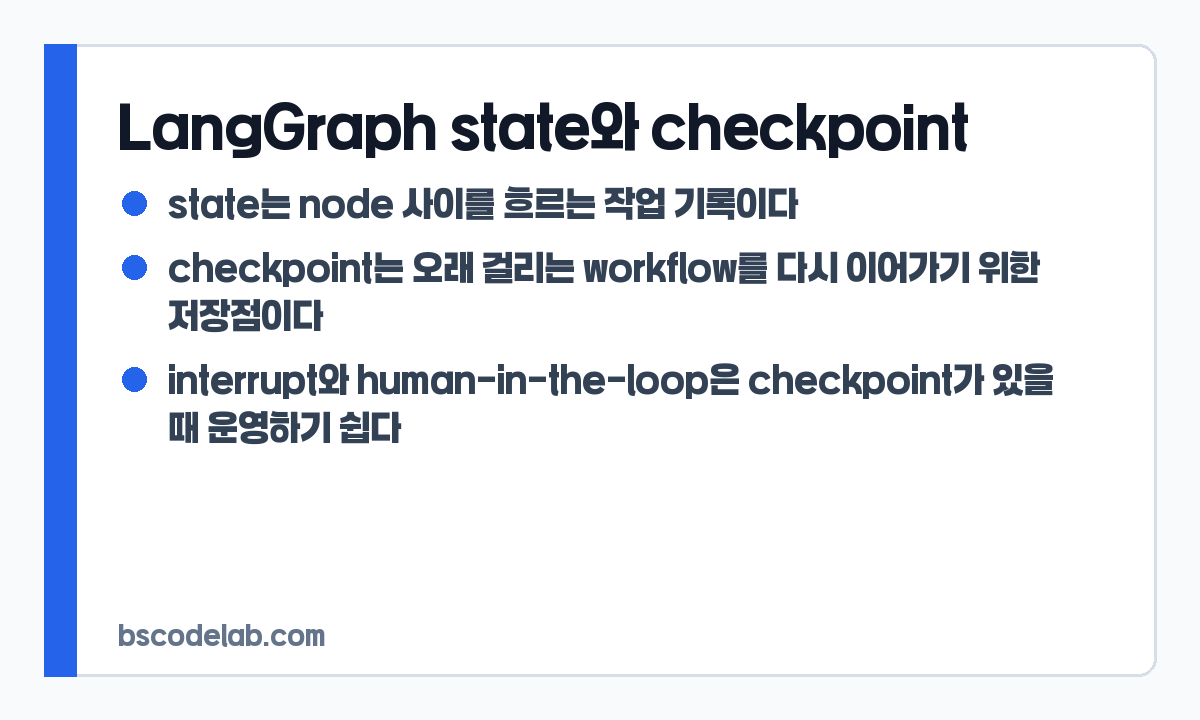
LangGraph에서 state는 graph 실행 중 여러 node가 함께 읽고 갱신하는 작업 상태입니다. 일반 함수에서는 인자를 넘기고 반환값을 받으면 끝나지만, graph 구조에서는 여러 단계가 같은 작업 문맥을 이어서 사용합니다.
예를 들어 문서 분석 workflow라면 질문, 검색된 문서, 요약 결과, 검토 상태, 사람이 수정한 메모가 모두 state에 들어갈 수 있습니다. 중요한 점은 state가 단순 전역 변수처럼 아무렇게나 변하는 값이 아니라, node 사이에서 어떤 키가 어떻게 갱신되는지 schema로 관리된다는 점입니다.
- 질문과 사용자 요청처럼 처음부터 있는 값
- 검색 결과와 중간 요약처럼 node가 추가하는 값
- 사람 승인 여부처럼 실행 도중 바뀌는 값
- 실패 원인이나 재시도 횟수처럼 운영에 필요한 값
checkpoint가 필요한 순간
작은 예제에서는 graph를 한 번 실행하고 끝내면 됩니다. 하지만 실제 workflow는 그렇지 않습니다. 모델 호출이 실패할 수 있고, 도구 호출이 오래 걸릴 수 있고, 사람이 승인해야 다음 단계로 넘어갈 수도 있습니다.
checkpoint는 이런 상황에서 현재 state를 저장합니다. 실행이 중간에 멈추거나 사람이 나중에 돌아와도 같은 thread의 state를 다시 불러와 이어갈 수 있습니다. 그래서 checkpoint는 단순 로그가 아니라 재개 가능한 실행 구조의 기반입니다.
user request
  -> node: plan
  -> node: retrieve data
  -> checkpoint saved
  -> interrupt for human review
  -> resume with edited state
-> node: final answerstate schema를 먼저 잡아야 하는 이유
state를 대충 dict처럼 쓰면 처음에는 빠르게 보입니다. 하지만 node가 늘어나면 어떤 값이 필수인지, 어떤 값은 누가 갱신하는지, 같은 키를 여러 node가 동시에 갱신하면 어떻게 합칠지 흐려집니다.
그래서 LangGraph에서는 state schema와 reducer 개념이 중요합니다. 메시지 목록처럼 계속 누적해야 하는 값과, 현재 단계처럼 마지막 값으로 덮어써도 되는 값은 갱신 규칙이 다릅니다.
from typing import Annotated, TypedDict
from operator import add

class AgentState(TypedDict):
    question: str
    retrieved_docs: Annotated[list[str], add]
    review_notes: Annotated[list[str], add]
final_answer: strinterrupt와 human-in-the-loop
AI workflow에서 사람 검토가 들어가면 상태 저장은 더 중요해집니다. 사람이 검토하는 동안 프로세스를 계속 붙잡아 둘 수 없고, 며칠 뒤 같은 작업을 이어가야 할 수도 있습니다.
interrupt는 graph 실행을 의도적으로 멈추는 지점입니다. 예를 들어 에이전트가 만든 초안을 바로 발행하지 않고 사람이 확인하게 만들 수 있습니다. 이때 checkpoint가 있으면 검토 전 state와 검토 후 입력을 자연스럽게 이어 붙일 수 있습니다.
운영에서 자주 하는 실수
- state에 모든 원문 데이터를 계속 쌓아 context와 저장 비용을 키운다
- node별 책임을 나누지 않아 어느 단계가 어떤 값을 만들었는지 추적하기 어렵다
- checkpoint를 로그처럼만 보고 재시작 설계와 연결하지 않는다
- human review 결과를 별도 데이터로만 저장하고 graph state와 동기화하지 않는다
작게 시작하는 설계 순서
- workflow에서 반드시 이어져야 하는 값을 먼저 적는다
- node가 읽는 값과 쓰는 값을 표로 나눈다
- 누적 값과 덮어쓰기 값을 구분한다
- 사람 검토가 필요한 지점에 interrupt를 둔다
- thread id와 checkpoint 저장소를 운영 기준으로 정한다
정리
LangGraph state와 checkpoint는 복잡한 agent를 멋있게 보이게 만드는 장식이 아닙니다. state는 작업이 어디까지 왔는지 보여주는 실행 문맥이고, checkpoint는 그 문맥을 잃지 않고 다시 이어가기 위한 저장점입니다.
관련해서 MCP RAG 차이: 지식 검색과 도구 연결, Agentic RAG란 무엇인가, AI 에이전트 실전 설계 시리즈를 함께 보면 AI agent 구조를 더 넓게 잡을 수 있습니다. 외부 기준은 LangGraph docs – Low-level concepts, LangGraph docs – Persistence, LangGraph docs – Human-in-the-loop를 확인했습니다.