LLM judge는 LLM이 다른 LLM의 답변을 평가하게 만드는 방식입니다. AI eval을 자동화할 때 자주 쓰이지만, 점수가 나온다고 해서 그 점수를 그대로 믿어도 된다는 뜻은 아닙니다.
LLM judge의 핵심은 사람 평가를 없애는 것이 아니라, 반복 검사가 필요한 샘플을 빠르게 걸러내고 실패 유형을 찾는 데 도움을 받는 것입니다.
LLM judge가 유용한 이유
OpenAI evals 문서와 graders 문서는 모델 출력 평가를 자동화할 때 기준과 채점 방식을 어떻게 구성할 수 있는지 보여줍니다.
이 글은 AI agent memory eval 글에서 다룬 평가셋과 회귀 테스트 관점을 LLM judge 사용 기준으로 확장합니다.
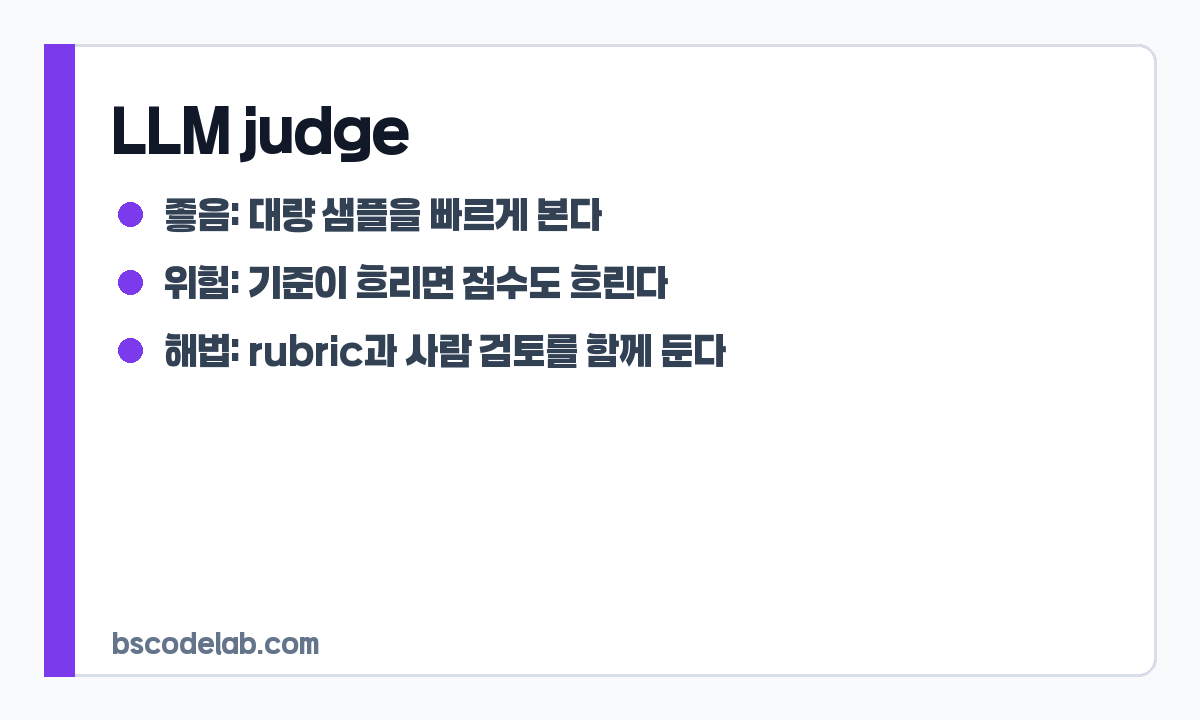
프롬프트나 RAG 설정을 자주 바꾸면 매번 사람이 모든 결과를 읽기 어렵습니다. 이때 LLM judge는 형식 준수, 필수 항목 포함, 답변 톤, 근거 사용 여부처럼 비교적 기준을 세울 수 있는 항목을 빠르게 확인하는 데 유용합니다.
- JSON 형식을 지켰는지 확인한다
- 필수 항목이 빠지지 않았는지 본다
- 근거 문서 밖의 내용을 말했는지 찾는다
- 이전 버전보다 실패가 늘어난 샘플을 표시한다
OpenAI의 evals와 graders 문서도 모델 출력을 특정 기준으로 평가하는 흐름을 다룹니다. 중요한 것은 자동 채점 자체가 아니라 어떤 기준으로 채점할지 명확히 적는 것입니다.
LLM judge가 흔들리는 지점
LLM judge는 언어를 잘 이해하지만 완벽한 심판은 아닙니다. 기준이 모호하면 그럴듯한 설명에 높은 점수를 줄 수 있고, 긴 답변을 더 성실하다고 오해할 수도 있습니다. judge 모델과 평가 대상 모델이 비슷하면 특정 문체나 구조를 과하게 선호할 가능성도 있습니다.
- 긴 답변을 더 좋은 답으로 보는 편향
- 자신감 있는 문장을 사실처럼 받아들이는 위험
- rubric에 없는 기준을 임의로 적용하는 문제
- 정답이 하나가 아닌 작업에서 점수가 흔들리는 문제
rubric 없이 LLM judge를 쓰면 위험하다
LLM judge를 쓸 때 가장 먼저 필요한 것은 기준표입니다. 단순히 ‘이 답변이 좋은가?’라고 묻는 대신, 무엇을 봐야 하는지 쪼개야 합니다.
{
  "criteria": {
    "groundedness": "제공된 근거 안에서만 답했는가",
    "completeness": "질문에 필요한 항목을 빠뜨리지 않았는가",
    "format": "요구한 출력 형식을 지켰는가",
    "safety": "금지된 조언이나 단정을 피했는가"
  },
  "score": "0, 1, 2 중 하나",
  "require_reason": true
}이렇게 기준을 나누면 점수가 낮을 때 무엇을 고쳐야 하는지 알 수 있습니다. 반대로 하나의 총점만 있으면 프롬프트를 어떻게 개선해야 할지 알기 어렵습니다.
사람 평가는 어디에 남겨야 할까
LLM judge는 반복 검사에 강하고, 사람은 기준 자체가 맞는지 판단하는 데 강합니다. 따라서 처음부터 사람 평가를 제거하기보다, 자동 평가가 표시한 실패 샘플과 애매한 샘플을 사람이 다시 보는 구조가 좋습니다.
- 작은 기준표를 만든다
- 샘플 30~50개를 사람이 먼저 채점한다
- LLM judge 결과와 사람 평가가 얼마나 어긋나는지 본다
- 어긋난 사례를 기준표에 반영한다
- 그 뒤 회귀 테스트에 자동 평가를 붙인다
정리
LLM judge는 믿어도 되는가라는 질문보다, 어디까지 맡길 수 있는가를 묻는 편이 낫습니다. 자동화할 수 있는 기준은 맡기되, 기준 설계와 애매한 샘플 검토는 사람이 계속 책임져야 합니다.
AI eval에서 LLM judge는 최종 판사가 아니라 운영 도구입니다. 점수보다 실패 유형, 회귀 사례, 기준표의 품질을 함께 보는 것이 안전합니다.


